Model bahasa yang sudah live
24 model live · Harga terbaru dalam rupiah ada di halaman Pricing.
Apa itu token dan kenapa memengaruhi biaya
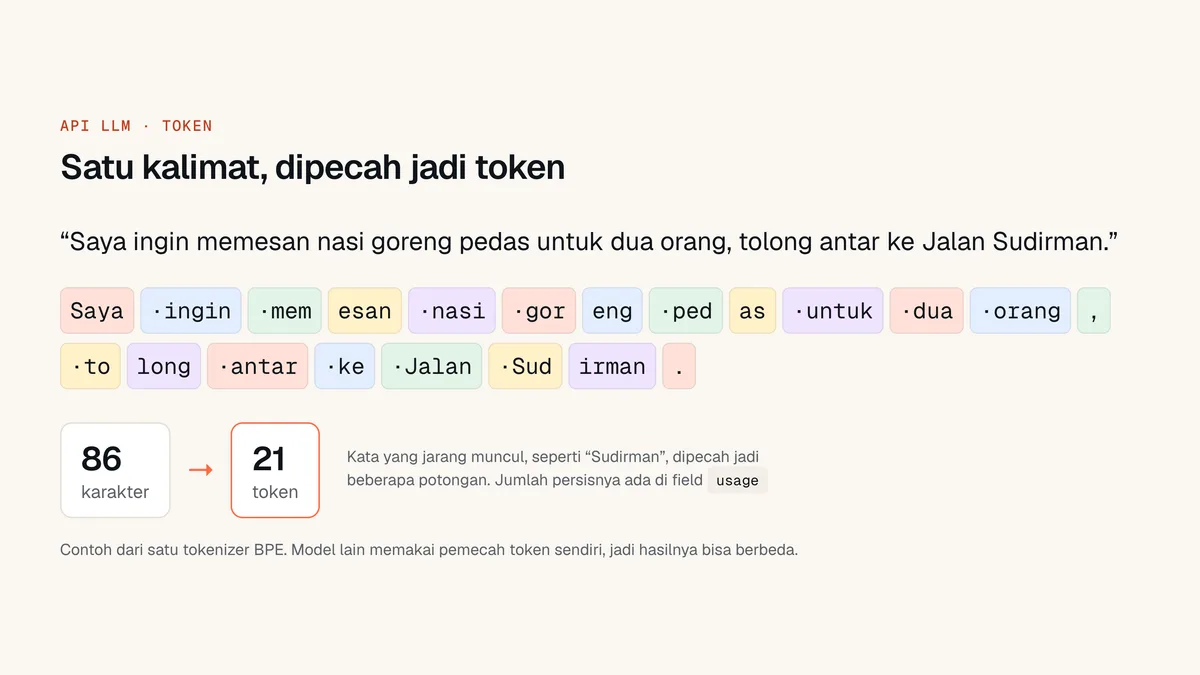
Model bahasa membaca dan menulis dalam satuan token, yaitu potongan kata. Biaya teks dihitung dari jumlah token input (prompt dan riwayat percakapan) dan token output (jawaban model).
Setiap model memakai pemecah token sendiri, jadi jumlah token untuk kalimat yang sama bisa berbeda antar model. Angka pastinya selalu ada di field usage pada setiap respons.
Fitur yang didukung
Streaming
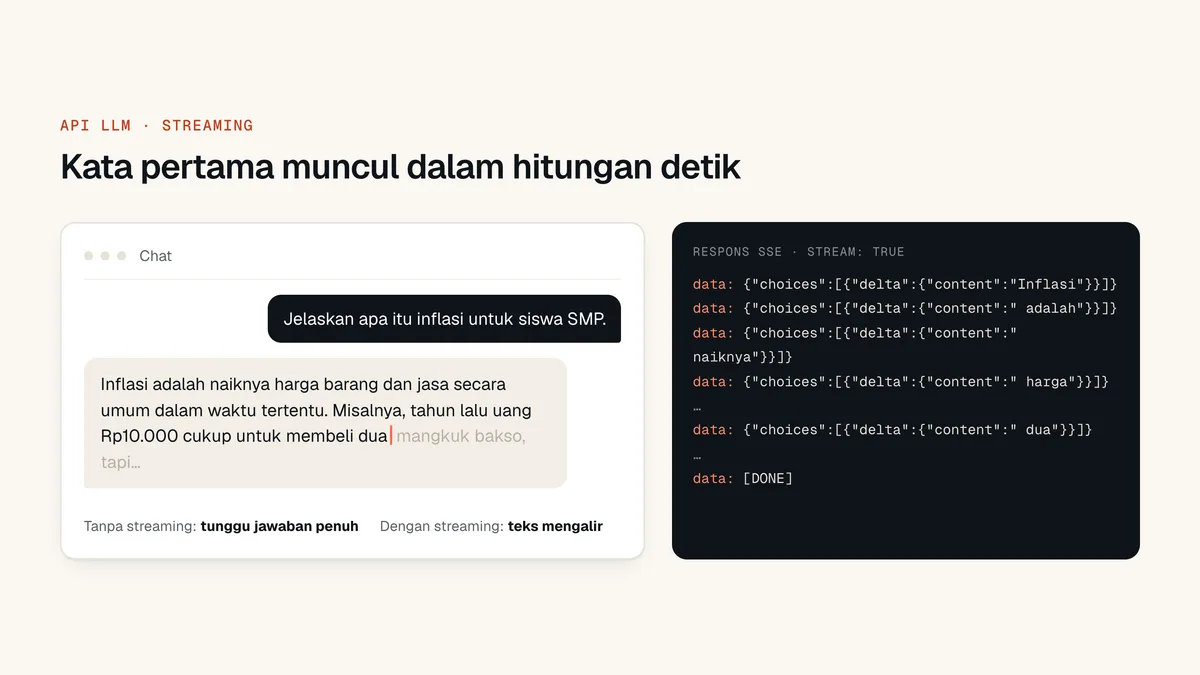
Kirim stream: true untuk menerima jawaban bertahap lewat SSE, diakhiri data: [DONE].
Tool calling
Field tools dan tool_choice didukung, termasuk pesan role: "tool" untuk mengembalikan hasil fungsi ke model.
Parameter standar
Parameter seperti temperature, top_p, stop, dan max_tokens diteruskan ke model yang mendukungnya.
Tahan koneksi putus
Kalau koneksi klien terputus di tengah jawaban, proses di server tetap selesai dan pemakaian token dicatat dengan benar.
Streaming untuk antarmuka chat
Tanpa streaming, pengguna menunggu sampai seluruh jawaban selesai. Dengan streaming, kata pertama muncul dalam hitungan detik sehingga aplikasi terasa jauh lebih cepat, walau total waktunya sama.
Contoh streaming
Memilih model sesuai tugas
| Tugas | Yang dicari | Tips |
|---|---|---|
| Klasifikasi, ekstraksi data | Cepat dan murah | Model berlabel flash atau lite biasanya cukup. |
| Chat customer service | Respons cepat, bahasa natural | Aktifkan streaming dan batasi panjang riwayat. |
| Menulis dan menganalisis kode | Model yang dilatih untuk kode | Cari model berlabel code di daftar model. |
| Penalaran panjang, dokumen kompleks | Model besar | Pakai hanya untuk langkah yang memang butuh. |
Daftar model dan harganya berubah dari waktu ke waktu. Cek GET /v1/models?modality=text atau halaman Pricing.
Pertanyaan seputar API LLM Indonesia
Format request API LLM AIport seperti apa?
Mengikuti format chat completions: field model, messages berisi role dan content, serta parameter opsional seperti temperature dan stream. SDK yang sudah mendukung format ini cukup diarahkan ke base URL https://aiport.id/v1.
Apakah mendukung tool calling?
Ya. Kirim tools dan tool_choice seperti biasa; model mengembalikan tool_calls, dan hasil fungsi dikirim balik sebagai pesan role tool.
Bagaimana token dihitung dan ditagih?
Biaya dihitung dari token input, token input yang ter-cache, dan token output, dengan harga per 1 juta token sesuai model. Jumlah token per request ada di field usage pada respons.
Apa yang terjadi kalau saldo habis?
Request teks ditolak dengan HTTP 429 dan kode insufficient_quota. Setelah top up, request berikutnya langsung berjalan lagi.
Panggil model bahasa pertamamu
Satu API key, banyak model, bayar per token dalam rupiah.